热摸爽的热度到底是怎么算出来的?
1200 万热度,是不是有 1200 万人在看?把热摸爽的排序账本摊开:四项权重、75 分的算例、旧新闻的保鲜期,以及首页为什么不让一家包场。

如果你在热摸爽上看见一条“1200 万热度”的新闻,先别替它召集那 1200 万人。本站没有挨个点名,平台也没给我们交观众名单。
这个数字是根据榜单位置、出现来源和内容年龄算出来的展示值。它回答的是:在这一批内容里,哪条更值得先看?
我觉得这件事应该讲明白。热度数字很容易让人误会成阅读量,位数越多,误会还越有气势。下面把账摊开。
微博的热度,不能直接加上 GitHub 的星星
不同平台的数字不是同一把尺子。阅读、讨论、播放、点赞、项目新增星标,各有各的口径。直接放进一个总榜,大数字的平台会天然占便宜。
跨站排序先看相对名次。一张有 50 条内容的榜单,第一名拿到 1,第 25 名大约是 0.51,最后一名是 0。原平台的热度可以保留展示,但不直接拿来计算跨站总分。
这解决了单位不统一的问题,也留下一个取舍:小榜单和大榜单的第一名,都能拿满名次分。比较的是它在自家榜单上的位置,并没有证明两边受众规模一样大。
同一个事件合并多个来源时,名次取其中最好的那个。不能微博第一、知乎第二,就把两个名次分加起来;否则新闻还没变热,算盘先冒烟了。
基础分怎么算?拿一条新内容试试
当前基础分的四项权重是:
因素 | 权重 | 具体看什么 |
|---|---|---|
相对名次 | 37% | 在原榜单里排得多靠前 |
跨源出现 | 25% | 合并后包含多少个来源记录 |
时效 | 30% | 内容有多新,按分类调整年龄 |
来源系数 | 8% | 配置给各来源设置的倍率 |
前三项换成 0 到 1 的数,第四项使用来源倍率的平均值,按权重相加后乘以 100。
第四项容易被名字带偏:配置把它叫“健康度”,但当前代码没有启用抓取成功率评分,实际起作用的是预设来源系数。它也不检查新闻真假,不能把这 8% 当成“可信度认证”。
举个说明公式的假设算例:一条刚发布的内容,名次第一,来源系数是 1,其他调整先不算。只有一个来源时,基础分是 37+0+30+8=75。
同样条件下,两个来源是 87.5 分,三个来源大约 95 分,四个来源是 100 分。跨源这一项到四个来源就拿满 25 分,后面不会一直加。
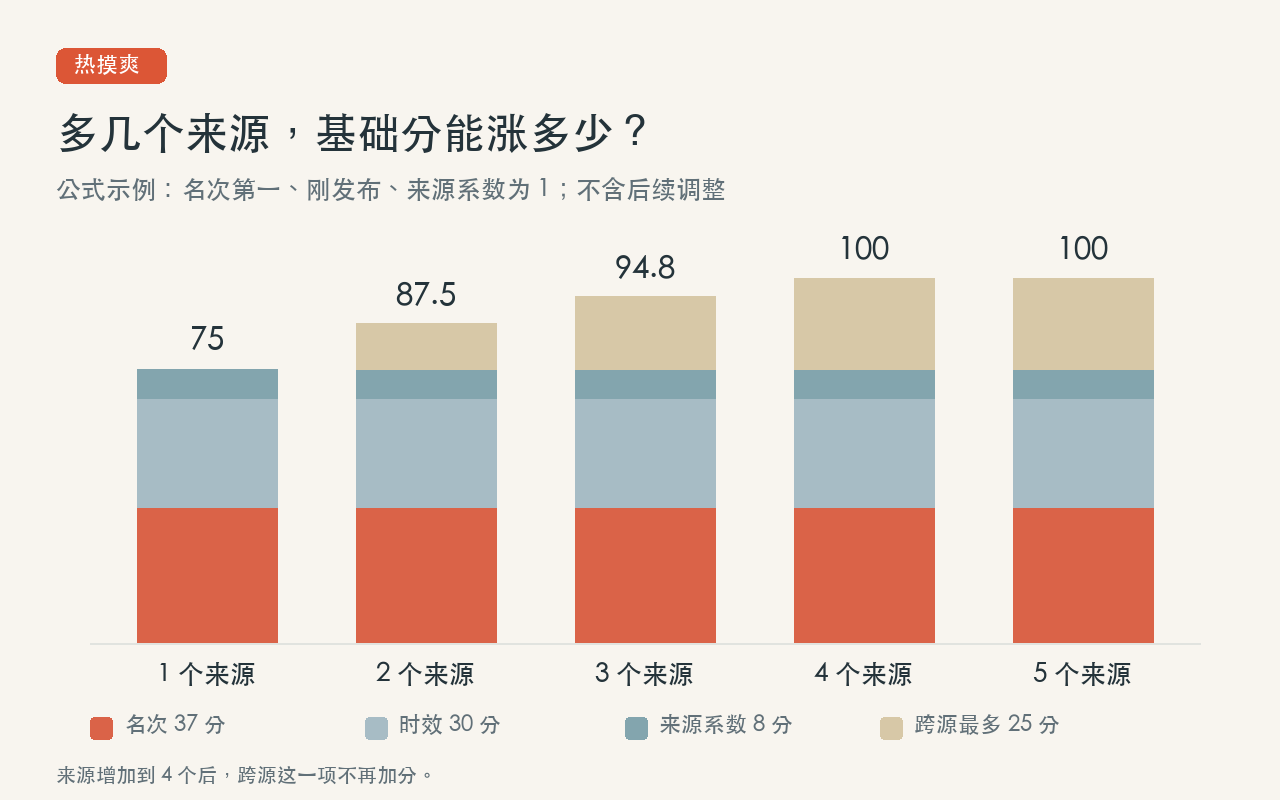
图 1:其他条件相同,来源从 1 个增加到 4 个,基础分从 75 涨到 100;第 5 个来源不再增加跨源分。图为公式算例。
这几笔账说明:独家消息即使又新又靠前,也没有跨源加分;多个来源出现的事件更容易往前走,但不能靠不断增加来源无限刷分。
我更愿意把这一项叫“传开了多少”。几家网站可能都在转同一篇稿子,多了几个链接,并没有凭空多出几个目击证人。
旧新闻不能靠刷新按钮返老还童
采集器刚抓到一条内容,只说明它刚被抓到,不能说明新闻刚发生。
计算会使用发布时间;发布时间和本站首次发现时间都有,就取较早的那个。缺发布时间时退回首次发现时间,两者都缺才继续用抓取等时间兜底。
首次发现仍可能比真正发布晚,这是采集的盲区。至少一条已经记录过年龄的旧内容,不会因为每轮重新采集就恢复青春。
时效分按指数曲线下降。按普通新闻的年龄口径,刚发布时这一项贡献 30 分,12 小时后大约剩 11 分,24 小时后大约剩 4 分。
整条分数还会降权:达到 12 小时档乘以 0.7,达到 24 小时档改为乘以 0.4。后一个档位替代前一个,不是连续乘两遍。只扣时效项,旧新闻还能靠名次和跨源分坐稳前排;整条降权才会给新内容让位置。
不过,娱乐话题和模型发布不该共用同一个保鲜期。当前 AI、知识类的年龄按六分之一计算,科技按二分之一,编程按三分之一。
一条 48 小时前的 AI 内容,会按 8 小时的年龄进入时效计算和分档降权。它依然会变旧,只是慢一些。更新没那么频繁的技术内容,也就多了一些留在榜上的机会。
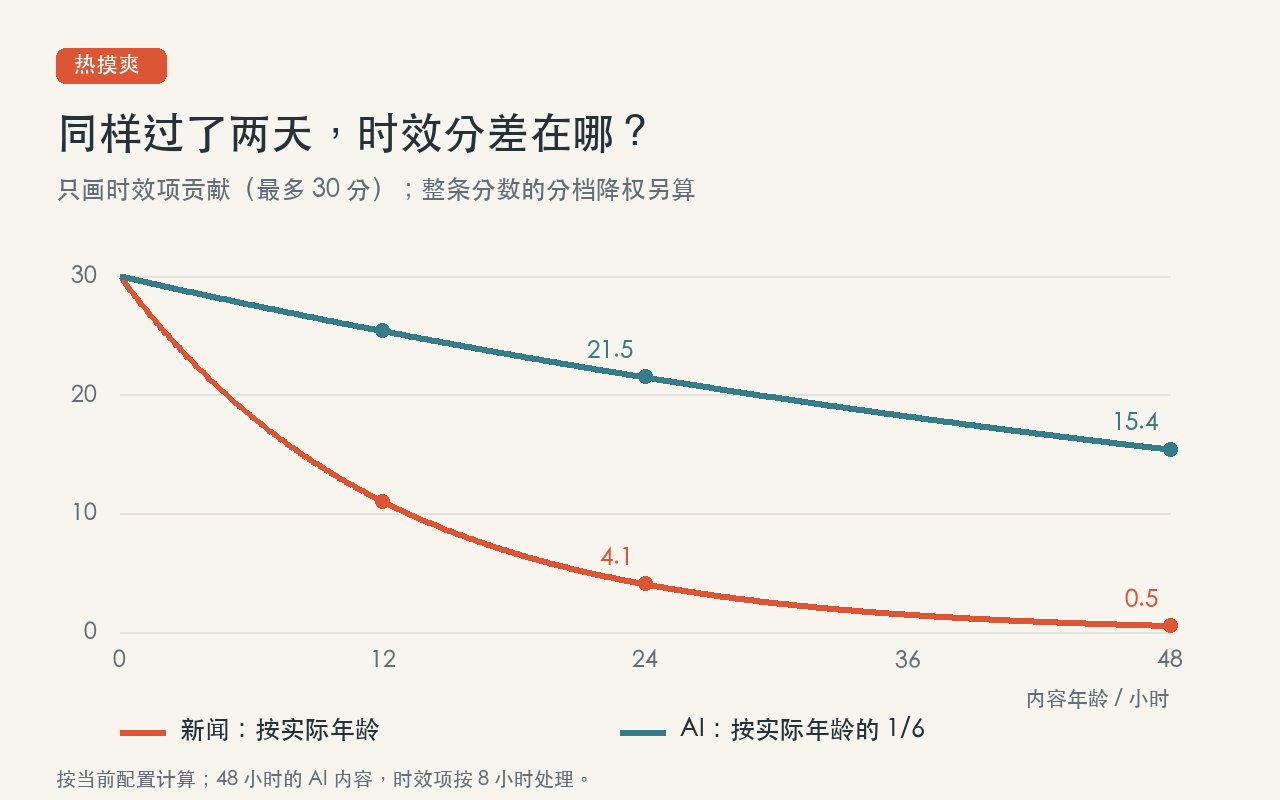
图 2:只比较时效项。48 小时后,新闻约剩 0.5 分,AI 约剩 15.4 分;这是分类保鲜期的差别,不是内容质量评分。
算完基础分,首页还要防止一家包场
基础分之后还有分类系数:当前 AI 乘 1.12,科技乘 1.08,编程乘 1.04,知识乘 1.02。这是明确的内容偏好,不是什么测出来的宇宙常数。总分也不严格封顶在 100。
首页、早报这样的跨源榜单,还会处理来源拥挤。同一展示来源的内容按分数排好,前两条不扣,第三条乘 0.78,第四条乘 0.78 的平方,大约剩六成。
来源发得勤快可以多收录,但首页座位有限,不能谁带的折叠椅多,谁就把整排占了。这是扣分,不是强行删掉第三条,也不用于本来就只展示一个来源的页面。
跨源榜单还偏向中文标题,当前非中文条目的分数乘以 0.45。看的是条目的语言,不是平台来自哪个国家。对应的来源页和分类页,没有套用这一整组首页规则。
我的判断是,承认这些偏好比宣称“算法完全中立”更有用。读者至少能知道,首页呈现的是本站做过取舍的结果。
那几千万热度,到底从哪儿来?
系统根据这一批内容的最低分、最高分和条目数量确定展示范围,再把各条分数换算进去。
这一步用了指数为 2.2 的曲线,并非简单地“分数乘一个固定数”。靠前内容的差距会被拉开,最后出现几百、几万乃至几千万的热度标签。
1200 万热度不等于 1200 万阅读,更不能推出 1200 万人在讨论。一条显示 200 万,另一条显示 100 万,也不代表前者有两倍受众。
还有个不太直觉的结果:某条内容自己的分数没变,只要同批列表的最高分或条目数量变了,它的展示热度也可能跟着变。所以它适合帮你扫当前榜单;判断跨时段是否升温,不能只拿两张截图里的“万热度”相减。
实际看榜时,我会先看它为什么靠前:是一个平台排得高,还是多个来源都出现了?发布时间多早?原文有没有新信息?
独家发布可能跨源分低,大量转载的旧消息可能链接很多。标题相似的内容可能被合并错,标题差别很大的同一事件又可能没合上,这些都会影响分数。
我希望这套排序能省掉你逐个平台翻榜单的时间。它把值得先看的线索往前放,哪条值得相信、哪条只是热闹,原文还是得打开。热度已经替你排过队了,没必要再让它替你做判断。
规则核对于 2026 年 10 月 3 日,依据当前排序代码与配置。公开说明见数据方法;计算实现见排序代码,具体参数以当时版本为准。
封面摄影:Carlos Muza,图片来自 Wikimedia Commons,CC0 公共领域授权。封面为主题配图,非本站后台截图;正文图表由热摸爽按上述公式绘制。
关于本文数据
- 数据来源
- 2026-10-03 核对 shared/signal-score.mjs、shared/heat-ranking.json 与本站数据方法页;文中分数为公式示例。